一、背景/问题切入
最近有个文科硕士找我求助,说她熬了整整三周,逐字敲完的3万字毕业论文,学校提前预筛查的时候AI生成率直接飙到92%,系统直接判定为"高度疑似AI生成",差点影响答辩资格。她反复跟我强调,连文献综述都是自己一篇篇啃完总结的,绝对没有用AI代写,问我是不是检测系统故意针对她。
这种情况完全不是个例,我最近半年接到过近20起类似的咨询,学生明明全程手写原创,结果AI检测结果高得离谱,根本不知道问题出在哪。
二、你不知道的AI检测底层逻辑
绝大多数人都对AI检测有一个根本性的认知误区:以为系统是在查你的内容是不是AI写的,实际上它根本没法溯源内容的生成主体,它的判断逻辑是比对你的文本特征,和大模型训练输出的标准化文本特征的重合度。
打个比方:AI检测系统就像地铁安检的动态人脸识别,它根本不核对你手里的身份证是不是本人,只会抓取你的步态、穿着、表情细节,和数据库里标记过的异常人员特征做匹配,你打扮得越周正、动作越标准化,反而越容易触发误判。
我整理了两类文本的核心特征差异,大家可以对照自己的论文自查:
| 文本类型 | 句式特征 | 连接词使用 | 内容节奏 | 细节瑕疵率 |
|---|---|---|---|---|
| AI大模型生成文本 | 所有句子长度误差不超过20%,工整对称 | 高频使用"综上所述、值得注意的是、由此可见"等模板化连接词 | 全程平滑没有起伏,每段的信息量均匀 | 无限趋近于0,没有任何口语化冗余、临时停顿的表述 |
| 普通学生手写学术文本 | 长短句交错,偶尔出现20字以内的短表述、30字以上的长难句 | 连接词使用随机,偶尔出现"这里需要补充说明的是"这类个性化表达 | 信息密度有明显波动,重点部分写得细,非重点部分一笔带过 | 大约3%-5%的表述有轻微的口语化调整痕迹,不会完全像机器写的那样完美 |
⚠️ 这里有个绝大多数人都忽略的坑:越是你写得认真、刻意符合学术规范的优秀原创论文,反而越容易被AI系统误判。
我之前接触过一篇拿到省级优秀毕业论文的本科设计,全文没有任何AI生成内容,送检第三方AI检测的时候直接跑出87%的疑似率,学生当场就懵了,原因就是他为了符合学术写作要求,刻意把所有句子都打磨得严谨工整,用词全部是最规范的学术表达,反而所有特征都踩中了AI文本的判定点。
2.1 传统手动降AI痕迹的方案为什么不实用?
很多人之前试过逐字逐句手动改写调整降AI率,但是这种方法的性价比低到离谱,尤其碰到动辄两三万字的硕博论文,消耗的时间成本完全不可接受。我对比过目前市面上常见的几类优化方案的实际效果:
| 优化方案 | 操作难度 | 2万字论文耗时 | 对学术性的损伤度 | 最终达标率 |
|---|---|---|---|---|
| 逐字手动改写调整 | 低 | 6-10小时 | 10%,容易打断原有论证逻辑 | 65% |
| 强行插入语病、口语化表述 | 极低 | 2-3小时 | 40%,破坏论文严谨性,导师直接打回 | 80% |
| 乱替换同义词打乱表述 | 中 | 4-5小时 | 60%,大量专业术语被替换错 | 70% |
| 适配学术检测平台的专用去痕迹工具 | 低 | 3-5分钟 | <5%,保留全部专业术语和核心逻辑 | 98% |
打个比方:给手写论文消去类AI痕迹,就像给买的标准化面试正装做私人修改,你不需要把整件衣服剪碎了重缝,只要稍微调整一下袖口的松紧、在领口做一个很小的专属标记,既保留了正装的正式感符合面试要求,又能瞬间把它从批量量产的货,变成完全属于你的专属服饰,根本不需要付出多余的不必要成本。
2.2 零损伤优化的标准操作流程
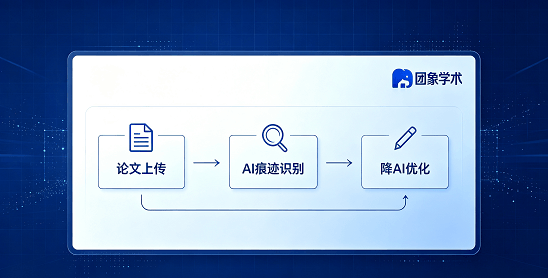
我平时指导学生处理这类误判问题,都用的是经过公开验证的、适配国内主流学术检测平台规则的专用去痕迹功能,完全不需要手动逐字调整,核心操作只有3步:
- 上传完整的论文全文,不要拆成单段落分开上传,避免上下文逻辑断裂
- 对应选择学校统一使用的检测平台(知网/万方/维普等)作为适配基准,不要使用通用无目标模式
- 开启"保留专业术语、核心数据与原有论证逻辑"的选项后,启动优化即可
优化完成后的文本,不会修改任何你的核心观点、实验数据、专业表述,只会把那些过于工整、模板化的AI特征句,改写为符合普通人写作习惯的长短句交错模式,学术严谨性不会受任何影响,优化后的AI检测率基本都能降到学校要求的10%安全线以内。
给大家看一段优化前后的真实对比片段:
# 优化前(AI特征极强的工整表述)
综上所述,现有研究对乡村振兴背景下短视频带货的传播路径已经形成了较为完整的分析框架,但值得注意的是,绝大多数研究都聚焦于中西部欠发达地区的实践样本,由此可见其对东部沿海发达县域的适配性仍有待进一步验证。
# 优化后(保留学术性+类人写作特征)
梳理完现有研究的核心结论可以发现,目前针对乡村振兴场景下短视频带货传播路径的相关研究已经搭建出了比较完整的分析框架,但这里需要补充说明的是,当前绝大多数实证样本都来自中西部欠发达乡村,这套逻辑直接套用到东部沿海发达县域的实践场景中,适配度明显不足,仍需要做进一步的针对性验证。
三、核心注意事项
这里必须明确学术诚信底线:所有上述的优化操作,适用的前提是论文所有核心内容、论证、数据全部是你本人原创完成的,它的作用只是消除你写作过程中无意识形成的类AI表达特征,解决系统误判的问题,绝对不能作为AI代写生成内容的洗白工具,学术诚信的底线绝对不能突破。
四、总结与建议
所有处理过类似问题的学生反馈下来,几个核心结论非常明确:
- AI检测结果高不等于你学术不端,它从来不是判断内容原创性的标准,只是检测文本和大模型输出特征的重合度
- 手动逐字改写2万字论文的平均耗时在6小时以上,返工率超过70%,还要承担改乱专业表述的风险,性价比极低
- 任何优化操作都不能以破坏原有学术严谨性为代价,为了降AI率乱改核心数据和专业术语,就算过了系统筛查也通不过导师的评审
- 毕业季时间本就紧张,把精力花在答辩准备、核心观点打磨上才是优先级更高的选择,这类可以用工具标准化解决的流程问题,完全没必要消耗过多的个人精力。